Alexandru BADIU, Responsable pôle Data Analytics chez Décilia & MVP Power BI
Sommaire
- Pourquoi la documentation devient si vite obsolète
- L’objectif : une documentation qui se reconstruit à chaque merge
- Standardiser le « pourquoi » : une skill qui vous interviewe
- Des fichiers à une application vivante
- Les leçons de la construction
- La vraie histoire : la puissance des systèmes agentiques
- Conclusion
Démo : documenter des signets avec un pipeline agentique.
Votre documentation est obsolète dès l’instant où vous l’enregistrez. C’est la réalité de la documentation aujourd’hui. On l’écrit une fois, le rapport évolue, et personne ne revient la mettre à jour. Six mois plus tard, cette documentation ne sert plus à personne.
Nous savons tous pourquoi, et nous en avons déjà parlé dans les articles précédents. La documentation ressemble à une taxe sur le « vrai travail ». La partie technique peut être fastidieuse, et la partie fonctionnelle, le pourquoi derrière un signet ou une mesure par exemple, n’existe que dans la tête de la personne qui l’a construit. Quand elle part, la connaissance part avec elle.
Voici donc la question à laquelle je voulais répondre.
Et si la documentation se reconstruisait à chaque merge, standardisait sa propre qualité et se publiait directement dans une application vivante que n’importe qui pourrait parcourir, à côté du modèle sémantique ? Non pas des fichiers périmés, mais un produit.
Est-ce impossible à réaliser dans ce nouveau monde de l’IA et des agents ?
Entrons dans le vif du sujet.
Vous héritez d’un projet Power BI. Vous ouvrez le dossier de documentation. Vous y trouvez un fichier Word du printemps dernier, ou rien du tout.
Les faits techniques sont récupérables. Vous pouvez lire le modèle, lister les mesures, compter les visuels. C’est fastidieux dans un PBIX, plus faisable en PBIP ou avec un notebook Fabric.
Voici le point essentiel à retenir : la vraie perte, c’est la couche fonctionnelle. Le JSON ou le TMDL n’en contient rien.
Pourquoi ce signet existe-t-il ? Quand faut-il l’utiliser ? Que se passe-t-il quand on clique dessus ?
Personne ne consigne cela dans le fichier.
Même la documentation générée par l’IA dérive. Vous pouvez générer aujourd’hui une magnifique documentation. Mais si personne ne relance la génération après la prochaine modification, vous revenez à un instantané qui vieillit mal.
Important
Le problème n’a jamais été d’écrire la documentation. Le problème, c’est de la maintenir à jour.
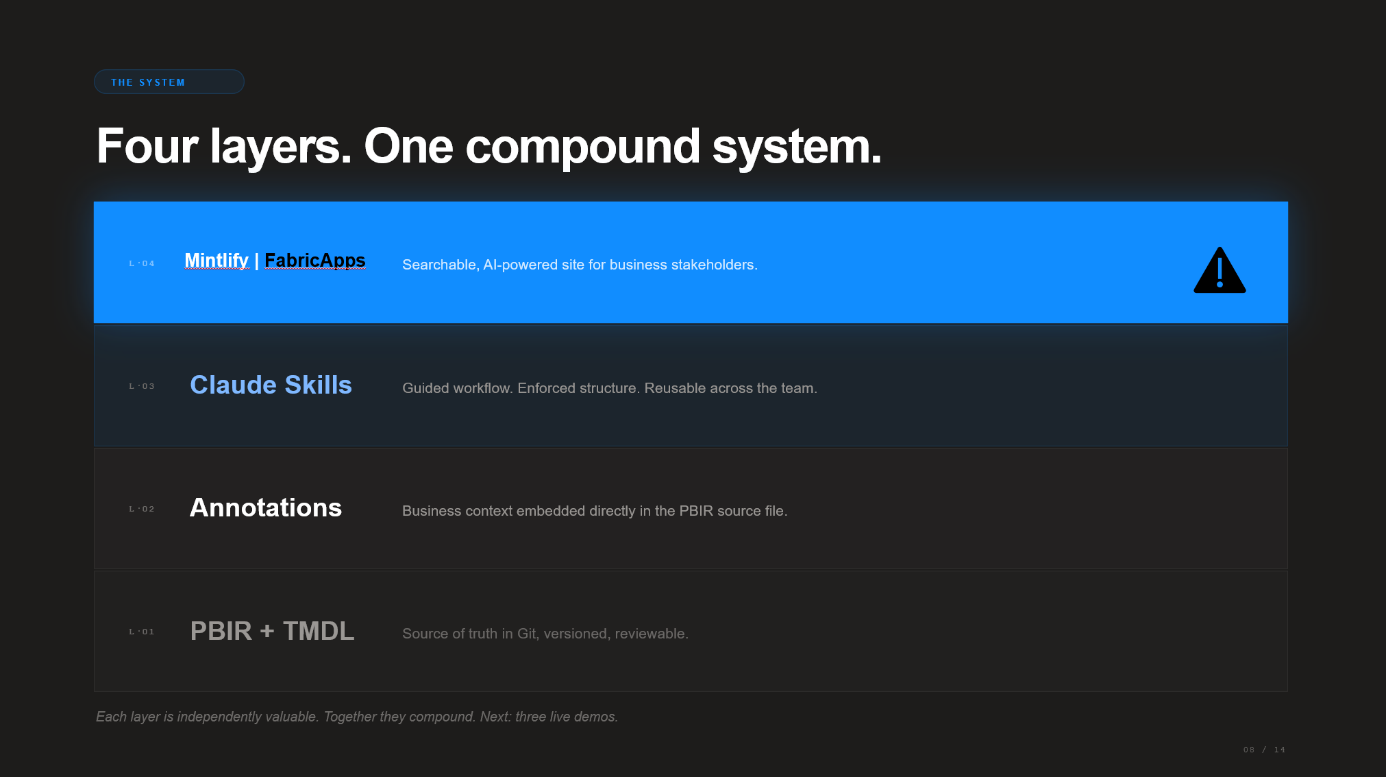
La solution consiste à arrêter de traiter la documentation comme un livrable.
Vous écrivez la source de vérité une seule fois, à l’intérieur du projet racine, à côté de ce qu’elle décrit. C’est là que la documentation devrait toujours vivre. À partir de là, un workflow agentique fait le reste.
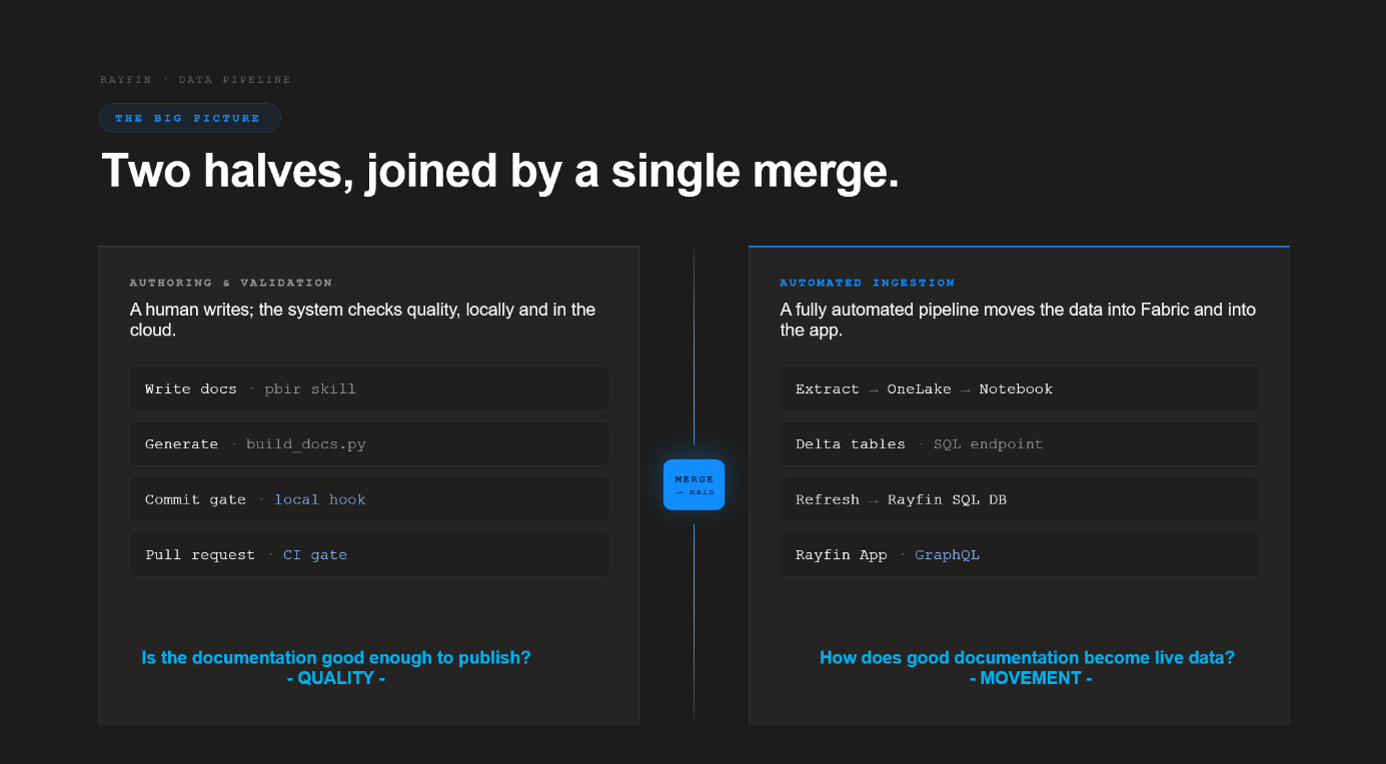
Chaque fois que quelqu’un merge une modification, le pipeline relit le projet, reconstruit la documentation, la valide et la pousse dans une application Rayfin en ligne. Personne ne copie quoi que ce soit. Personne n’a besoin de penser à « mettre à jour la doc ».
Voici la différence en pratique.
| Documentation traditionnelle | Documentation auto-actualisée | |
|---|---|---|
| Qui la met à jour | Un humain, un jour, peut-être | Le pipeline, à chaque merge |
| Source de vérité | Un fichier séparé qui dérive | Le projet lui-même |
| Fraîcheur | Inconnue, généralement périmée | Quelques minutes après le dernier merge |
| Cohérence | Dépend de qui l’a écrite | Imposée par un contrôle qualité |
| Où elle vit | Un dossier que l’on oublie | Une application en ligne que tout le monde peut parcourir |
Le merge est le déclencheur. Avant le merge, vous rédigez et vérifiez. Après le merge, une chaîne automatisée transporte le contenu jusqu’à une base de données SQL Microsoft Fabric qui alimente une véritable application web Rayfin. L’exécution complète se termine en quelques minutes.
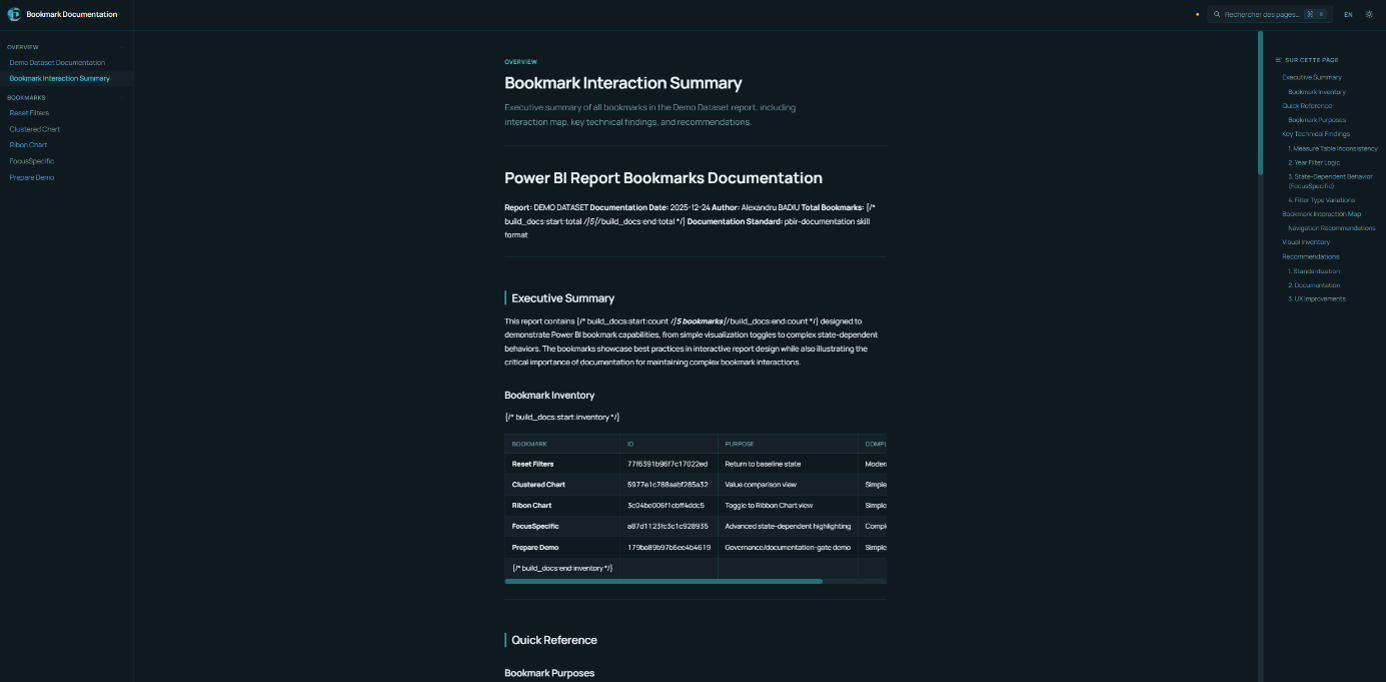
Le résultat final du workflow agentique décrit dans cet article est une application Rayfin qui documente les signets, à la fois sur le plan technique et fonctionnel.
Note
Ceci est un aperçu d’une idée plus large. L’application présentée ici tourne sur Rayfin, le framework Fabric Apps de Microsoft. Le principe, écrire une seule fois et laisser un pipeline garder tout à jour, s’applique bien au-delà d’un seul outil.
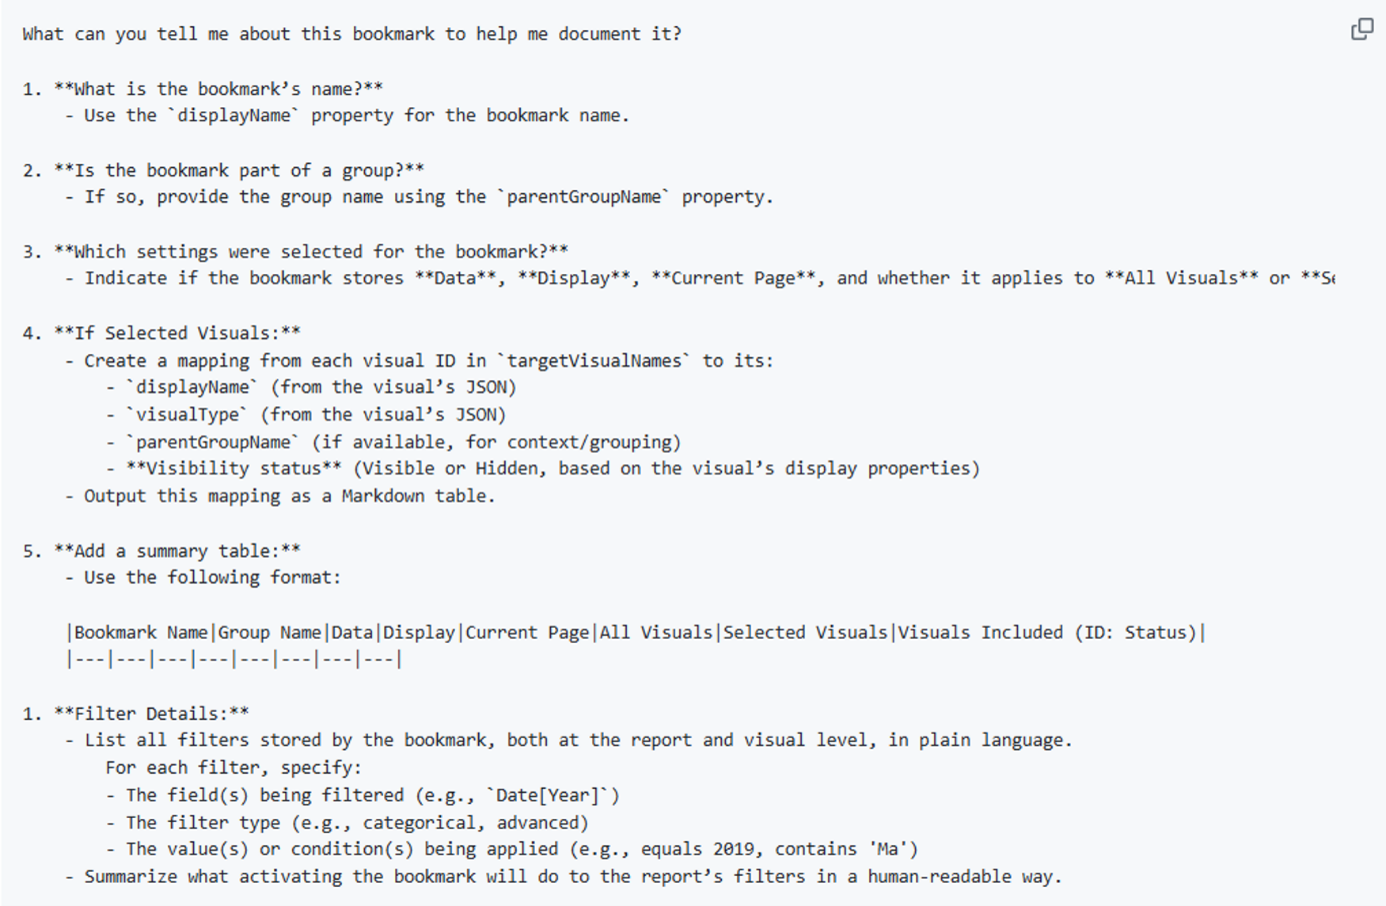
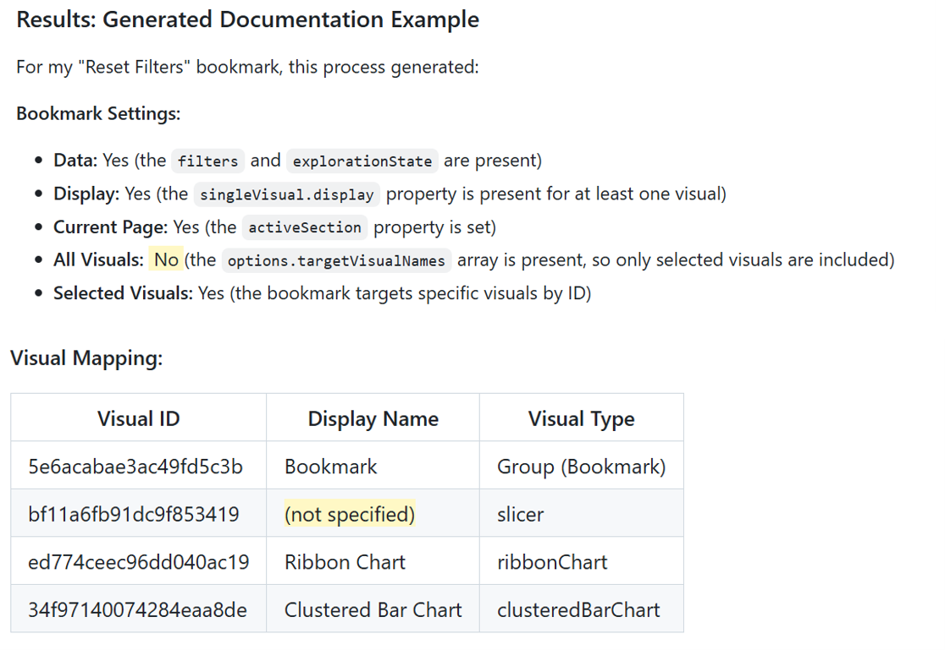
La documentation technique est facile à générer avec le bon prompt, invoqué et intégré dans les bonnes skills :
Attention
L’automatisation seule ne règle pas la couche fonctionnelle. Si les gens écrivent des descriptions incohérentes et à moitié vides, vous publiez simplement des descriptions incohérentes et à moitié vides plus rapidement.
C’est pourquoi une skill interviewe l’auteur et capture l’information fonctionnelle. Elle lit le signet, puis pose des questions ciblées, un sujet à la fois.
Quel est l’objectif métier ? Qui est l’utilisateur ? Que doit-il se passer ?
L’essentiel, c’est ce qu’elle fait quand la réponse est trop mince. S’il n’y a pas assez de contexte, elle repose la question. Elle sait à quoi ressemble une réponse « suffisante », et elle ne se contentera pas d’un « TBD » ou d’une réponse en un mot.
Mieux encore, un prehook vous empêche de committer vos nouvelles modifications (si vous utilisez l’IA pour vos commits) tant que vous n’avez pas documenté vos signets ou vos calculs visuels. C’est un cas d’usage plutôt astucieux, je dois dire. Vous n’avez même plus besoin de « penser » à documenter : le système vous dit quand il faut le faire.
Cela ressemble enfin à un processus de documentation qui passe à l’échelle !
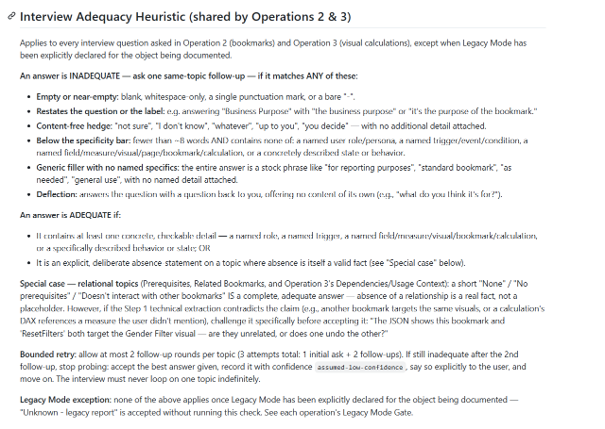
L’annotation générée, après validation, vit à l’intérieur du fichier JSON du rapport : elle voyage avec le rapport au lieu de dériver vers un wiki séparé. Une skill guidée se charge de la rédaction : elle demande à quoi sert le signet, quand quelqu’un l’utiliserait, ce qui doit se passer au clic, puis elle écrit deux choses :
- Une annotation structurée dans le JSON du rapport.
- Une page Markdown correspondante, avec le frontmatter qui la place dans la navigation.
Remarquez le sens de la vérité : si quelqu’un oublie la description de la page, le générateur la reprend automatiquement depuis l’annotation. Le JSON fait autorité ; la page Markdown en est une projection, pas un document indépendant.
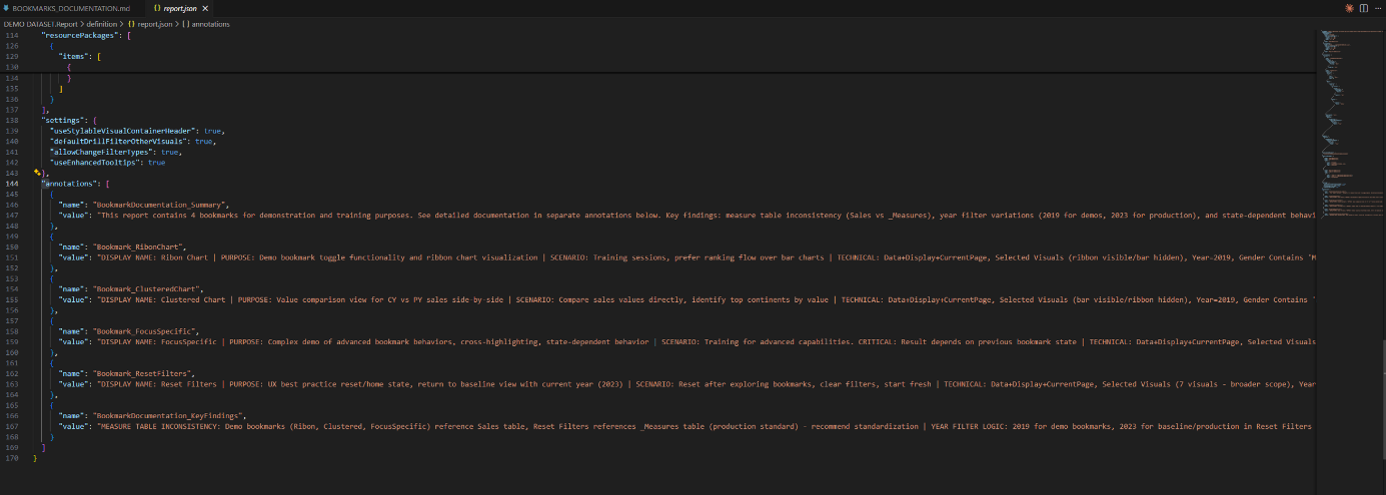
Et deux contrôles qualité viennent appuyer le tout.
✅ Un contrôle local bloque un commit si la documentation d’un signet est manquante ou remplie de placeholders.
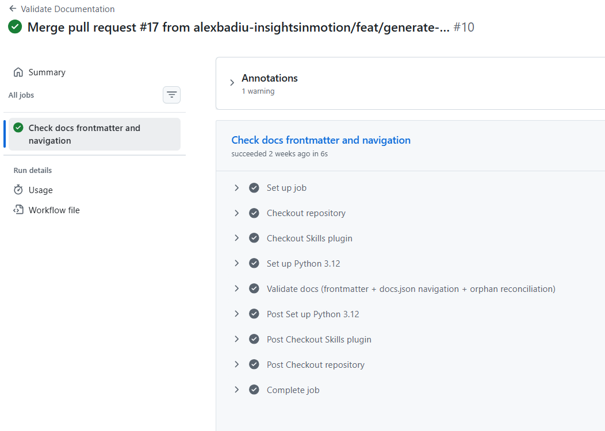
✅ Un contrôle dans le cloud (sur GitHub) relance les mêmes vérifications sur chaque pull request, si bien que rien d’incomplet n’atteint jamais la branche principale.
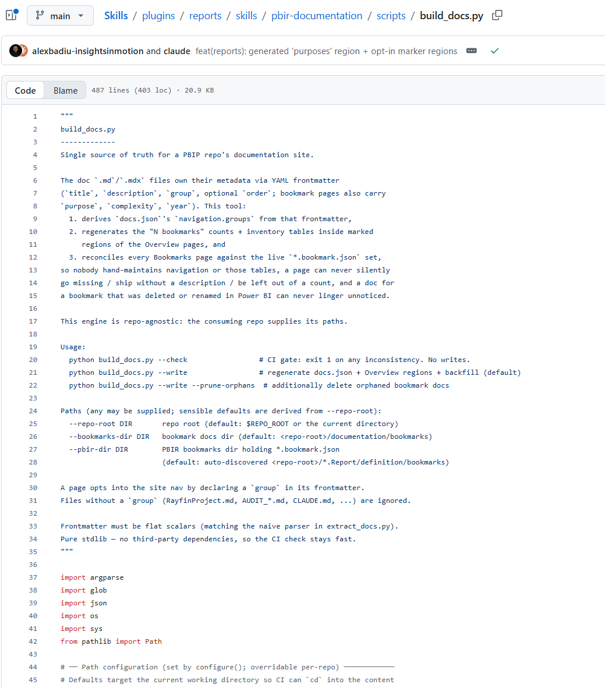
Le résultat : une standardisation par construction.
La documentation n’est pas seulement toujours à jour.
La skill et les contrôles donnent à chaque entrée la même forme,
et aucun des deux n’accepte moins.
Astuce
Demandez à votre outil de documentation de vous challenger, pas seulement de vous enregistrer. Une skill qui conteste une réponse faible produit une meilleure documentation qu’une skill qui accepte tout ce que vous tapez.
C’est ici que l’on cesse d’avoir un dossier de documentation pour commencer à avoir un produit.
Comme le pipeline extrait tout, et pas seulement les pages, l’application peut montrer bien plus que de la prose. Elle capture les pages de documentation, les mesures du modèle sémantique, les tables et les relations, ainsi que chaque visuel du rapport avec ses métadonnées d’accessibilité. Le tout atterrit dans Fabric sous forme de tables structurées.
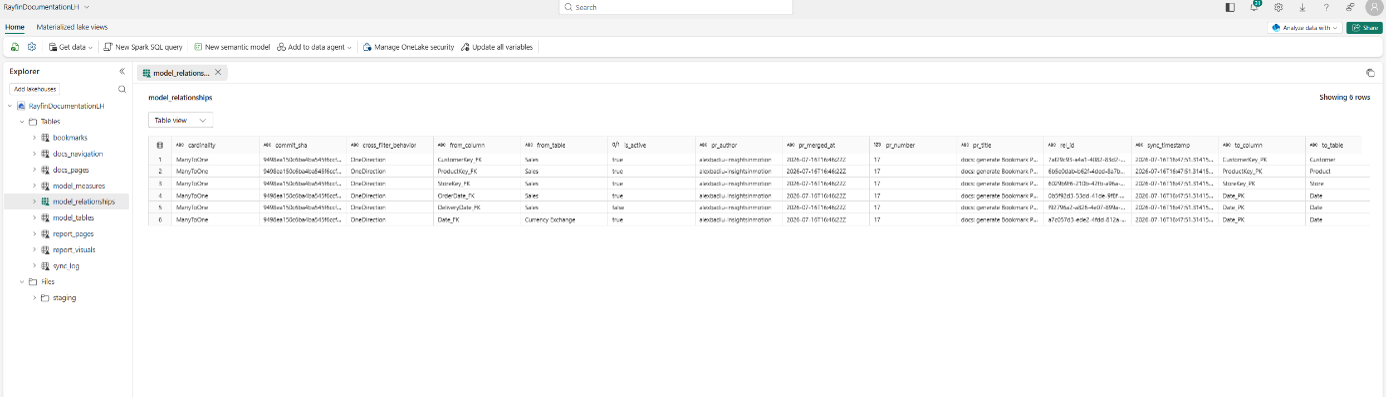
L’application lit ces tables et les transforme en vues :
- Un catalogue de mesures consultable.
- Une vue d’ensemble du modèle avec ses relations.
- Un inventaire des visuels du rapport qui signale ceux sans texte alternatif.
- Des analyses détaillées des signets, avec le « pourquoi » fonctionnel associé.
- Un badge « dernière synchronisation » pour que chacun voie la fraîcheur des données.
C’est là le vrai déclic.
Vous n’avez pas construit une pile applicative complète.
Vous avez écrit de la documentation et défini un pipeline.
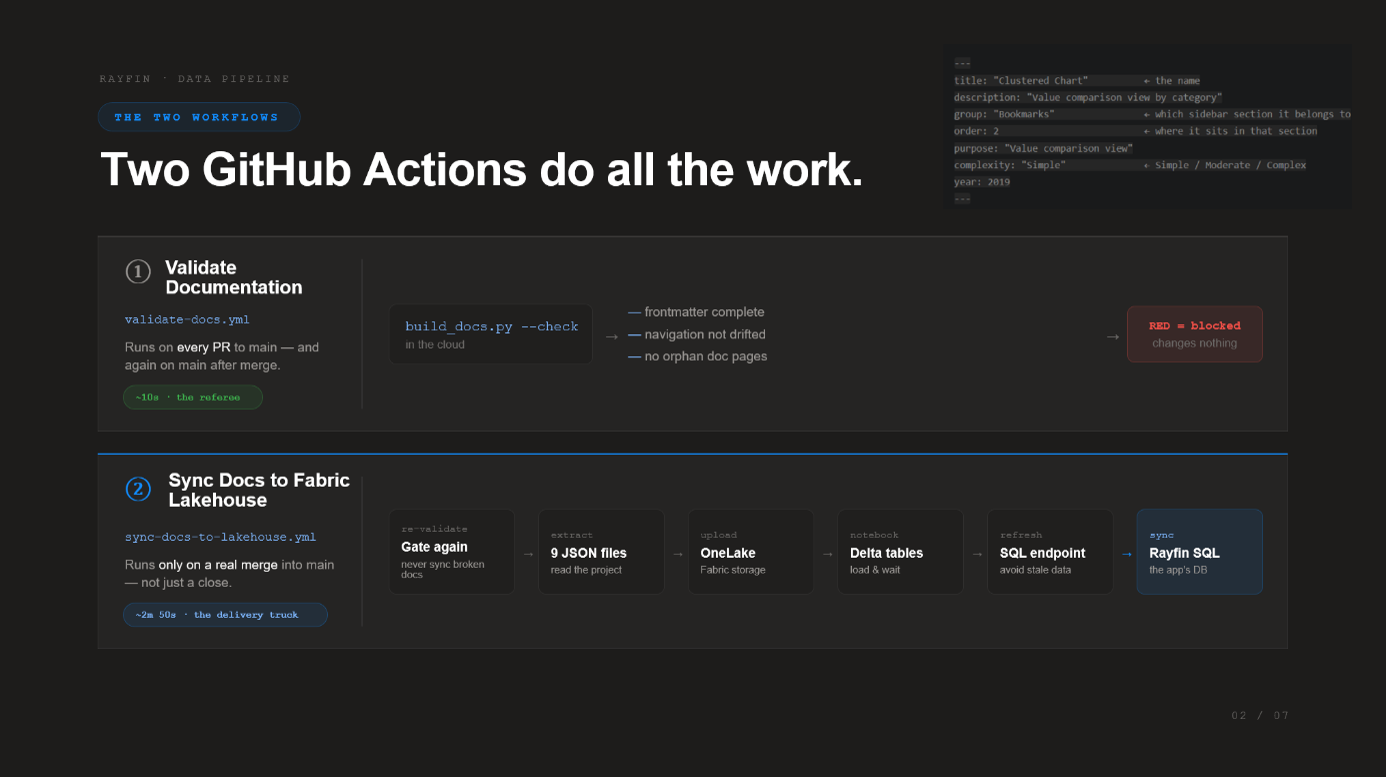
Seules deux GitHub Actions font tout le travail, et il est utile de bien les distinguer.
La première, Validate Documentation, est l’arbitre : elle s’exécute sur chaque pull request, puis à nouveau sur main après le merge, en lançant build_docs.py --check dans le cloud. Son seul rôle est de confirmer que la documentation est complète et cohérente : frontmatter renseigné, navigation sans dérive, aucune page orpheline pointant vers des signets qui n’existent plus. Si quelque chose ne va pas, l’exécution passe au rouge et le merge est bloqué. Elle ne modifie rien ; elle vérifie seulement (c’est pourquoi c’est l’exécution rapide, d’environ 10 secondes).
La seconde, Sync Documentation to Fabric Lakehouse, est le camion de livraison. Elle ne s’exécute que lorsqu’une PR est réellement mergée dans main, et elle enchaîne tout le relais d’ingestion dans l’ordre : relancer le contrôle de validation pour ne jamais synchroniser une documentation cassée, extraire le projet en neuf fichiers JSON, les téléverser dans OneLake, exécuter le notebook Fabric qui charge les tables Delta et attendre qu’il termine, rafraîchir le point de terminaison SQL pour qu’il ne soit pas périmé, puis tout synchroniser dans la base de données SQL de l’application Rayfin. C’est l’exécution la plus lente, environ 2 min 50 s, car elle déplace les données jusque dans Fabric.
L’application, vous l’obtenez gratuitement au bout de la chaîne. Un dépôt est discrètement devenu un portail de connaissances interne qui se met à jour tout seul.
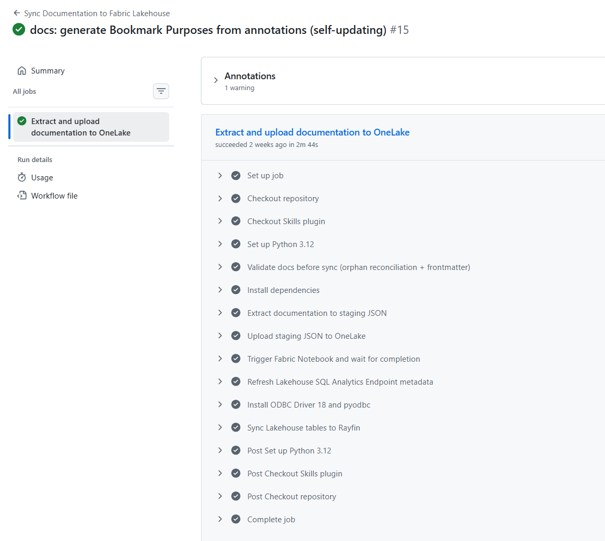
Rien de tout cela ne s’est fait sans accroc. Le pipeline a cette forme parce qu’il s’est heurté à de vrais murs, et chaque étape étrange corrige l’un d’eux. Si vous construisez quelque chose de similaire, attendez-vous à ceci.
Leçon 1 : la porte d’entrée normale de l’application refuse les machines. La couche GraphQL de Rayfin n’accepte qu’une connexion humaine et refuse le service principal utilisé par l’automatisation. Le pipeline la contourne donc et écrit directement dans la base de données SQL. GraphQL est un chemin de lecture pour les humains, pas un chemin d’écriture pour les machines.
Leçon 2 : « le job est terminé » ne veut pas dire « les données sont visibles ». Le point de terminaison SQL de Fabric rattrape les nouvelles données en arrière-plan, pas instantanément. Lors d’un merge, un signet nouvellement ajouté n’a jamais atteint l’application, sans le moindre message, parce que la synchronisation avait lu l’ancien instantané. La correction tient en deux couches : forcer un rafraîchissement, puis vérifier que le nombre de lignes correspond avant d’écraser quoi que ce soit, en échouant bruyamment plutôt que d’écraser de bonnes données avec un jeu incomplet.
Leçon 3 : être Admin de l’espace de travail ne suffit pas. Une base de données SQL Fabric possède sa propre liste d’autorisations. Être Admin de tout l’espace de travail n’ouvre pas cette porte-là. Il faut partager l’élément base de données avec le service principal à la main, dans le portail, car il n’existe pas d’API pour cela.
Leçon 4 : la base de données s’endort. Les bases de données SQL Fabric se mettent en pause lorsqu’elles sont inactives, et les connexions échouent tant que vous ne les réveillez pas en ouvrant l’élément une fois dans le portail. Ajoutez une note « la réveiller » à vos étapes de mise en place.
Leçon 5 : laissez la base de données créer ses propres identifiants. Chaque table génère automatiquement sa clé primaire. Essayer d’insérer la vôtre fait échouer l’écriture. Omettez-la et laissez la base de données faire son travail.
Leçon 6 : les environnements de build automatisés cachent des pièges. Un interrupteur conditionnel « ignorer cette étape » ne pouvait pas lire directement un secret masqué : il faut d’abord copier le secret dans une variable normale. L’installation du pilote de base de données échouait sans cesse parce qu’elle attendait des réponses au clavier sur une machine sans clavier : il faut ajouter des options qui disent « oui, en silence, fais confiance ». Attendez-vous à des frictions de mise en place, et consignez les correctifs.
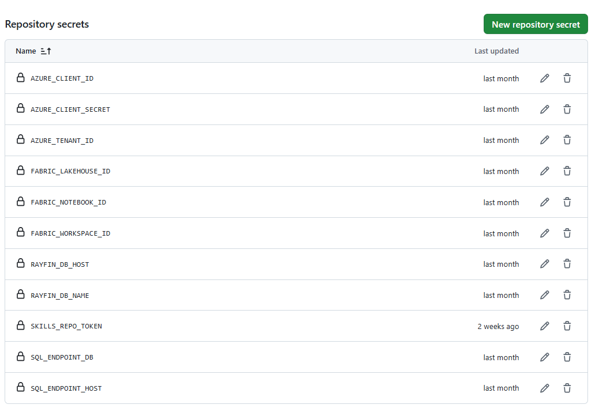
S’il ne fallait retenir qu’une chose de cette section : quand vous copiez un pipeline comme celui-ci, copiez aussi les correctifs, pas seulement le scénario idéal.
Prenez du recul : le principe dépasse largement la documentation.
Ce n’est pas un script qui copie des fichiers à l’aveugle. C’est un système agentique. Il interviewe un humain pour capturer son jugement.
Il valide sa propre production et refuse de publier quand la qualité est insuffisante. Il déplace des données à travers trois systèmes, attend que les étapes lentes soient réellement terminées, vérifie que ce qu’il a écrit est bien là, et échoue proprement quand ce n’est pas le cas.
La magie tient dans ce partage. Les parties déterministes, extraction, téléversement, chargement, synchronisation, tournent comme une mécanique fiable. Une skill prend en charge les parties qui demandent du jugement, comme « cette description fonctionnelle est-elle suffisante ? », et elle peut contester et reposer la question.
De la mécanique là où vous voulez de la fiabilité. Du jugement là où vous voulez de la qualité.
À vous de jouer
Essayez par vous-même. Vous n’avez pas besoin de Fabric pour commencer. Pointez une skill d’IA vers votre propre projet.
✅ La documentation devient vite obsolète parce que c’est un instantané. Faites-en un produit du dépôt, reconstruit à chaque merge.
✅ La vraie perte, c’est le « pourquoi » fonctionnel. Capturez-le avec une skill qui vous interviewe et repose la question quand le contexte est trop mince.
✅ Deux contrôles la maintiennent correcte. L’un en local, l’autre dans le cloud, pour que rien d’incomplet n’atteigne la branche principale.
✅ La récompense, c’est une application vivante. Un dépôt devient un portail de connaissances qui se met à jour tout seul, pas un dossier que l’on oublie.
✅ Les étapes étranges sont des leçons, pas du désordre. Chaque correctif vient d’un vrai échec qui mérite d’être documenté. Cela ne fera que se simplifier. J’ai déjà créé 2 idées Microsoft pour faciliter la documentation directement dans Power BI, sans avoir à « sortir des sentiers battus » et à recourir aux annotations.